LLM 上線前評估清單:如何測試 AI 工具
GitHub 的 LLM 評估指南提醒團隊與使用者,AI 工具必須用真實任務、人工審查與回歸測試驗證後才能進入重要流程。
本文速讀
This article covers LLM 上線前評估清單:如何測試 AI 工具. GitHub 的 LLM 評估指南提醒團隊與使用者,AI 工具必須用真實任務、人工審查與回歸測試驗證後才能進入重要流程。
重點
- Published: September 1, 2026
- Category: AI Software
- Tags: LLM evaluation, AI tools, production AI, developer workflow, software testing
- Views: 387
- Reading time: ~3 min read
"GitHub 的 LLM 評估指南提醒團隊與使用者,AI 工具必須用真實任務、人工審查與回歸測試驗證後才能進入重要流程。"
重點速讀
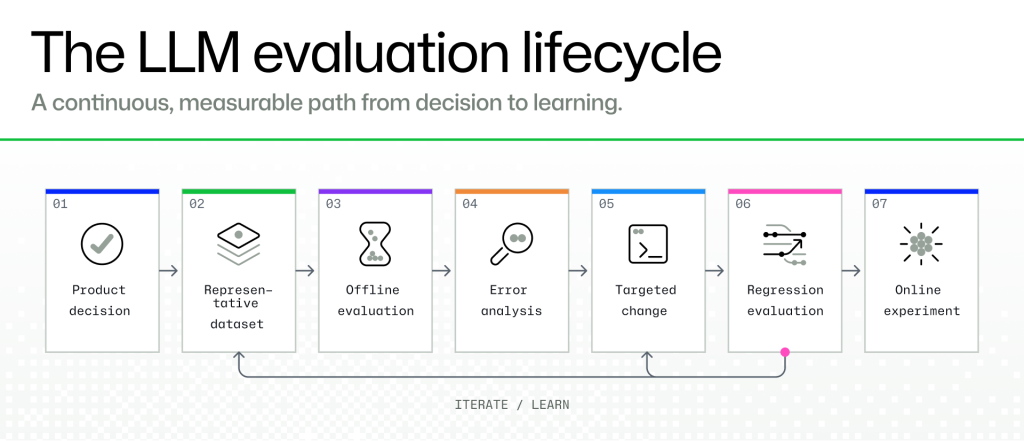
GitHub 最新的 LLM 上線前評估文章 https://github.blog/ai-and-ml/llms/how-to-evaluate-llms-before-production/ 說明,選擇 AI 工具不能只看展示效果。可靠流程應先定義產品決策,建立代表性案例,執行離線測試,讓人類審查低信心與高影響輸出,接著做針對性修改、回歸檢查與小範圍上線。對 BTTC 讀者而言,這也適用於程式碼助手、文件摘要器、自動化工具與任何準備下載的 AI 軟體。
為何此刻必須重視 LLM 評估
AI 功能已進入日常工作。團隊用它審查 pull request、摘要文件、回覆客服、分類工單、搜尋程式碼與自動化重複任務。模型選項也快速增加,從 GitHub Copilot、雲端 API、本機模型到瀏覽器代理都有。因此使用者真正需要回答的是:在 AI 觸碰重要工作前,如何知道它足夠可靠?
先界定任務決策
不要從排行榜開始,而要從任務開始。你是要選程式碼搜尋助手、客服機器人、PDF 摘要器,還是能編輯檔案的代理?每種任務風險不同。程式碼工具要保留測試並解釋差異;客服工具不能編造政策;研究助手必須引用來源並區分事實與猜測。
建立真實但可管理的測試資料
不一定需要大型基準,但需要能暴露失敗模式的案例。放入簡單案例、模糊案例、高影響案例,以及應該拒絕或要求澄清的情境。個人可用十到三十個真實任務比較工具;團隊則應標註期望輸出並留下理由。人工審查仍然重要,因為平均分數可能遮住高風險錯誤。
讓評估成為軟體品質流程
好的 AI 評估應像正常軟體工程。把提示詞、資料集、模型設定與評分紀錄納入版本管理;修改提示詞或替換模型前先跑離線測試;修正問題後重新跑舊案例,避免新的破壞。若風險較高,先小量上線並保留回滾方式。建立工具流程時,可到 https://www.bttc.site/software 比較編輯器、測試工具、PDF 工具與安全輔助軟體。
信任工具前的實用檢查
先寫下任務與錯誤代價。再用代表性資料測試,而非只看供應商範例。接著評估準確性、引用、速度、成本、拒絕品質、隱私與復原能力。影響使用者、金錢、安全或法規的輸出要由人審查。每次提示詞、模型、資料來源或權限改變都應重跑回歸測試。更多選型內容可見 https://www.bttc.site/blog 。
常見問題
LLM 評估只屬於開發者嗎?
不是。開發者需要正式測試,一般使用者也能用真實任務、來源檢查、權限審查與小規模試用比較 AI 應用。
AI 工具最大的警訊是什麼?
如果工具自信回答卻沒有來源、審查控制、記錄或回滾方式,就不適合處理重要工作。
團隊何時應重新評估?
當提示詞、模型、檢索來源、權限或產品行為改變時,就應重新執行評估。
結論
LLM 評估正在成為軟體選擇的基本能力。能用真實工作測試、從錯誤中學習並保留人工驗證的團隊,會比盲目追逐新模型更穩健。