LLM 上线前评估清单:如何可靠测试 AI 工具
GitHub 最新的 LLM 评估指南提醒团队和个人:不要只看演示效果,而要用真实任务、人工复核和回归测试判断 AI 工具。
本文速读
This article covers LLM 上线前评估清单:如何可靠测试 AI 工具. GitHub 最新的 LLM 评估指南提醒团队和个人:不要只看演示效果,而要用真实任务、人工复核和回归测试判断 AI 工具。
要点
- Published: September 1, 2026
- Category: AI Software
- Tags: LLM evaluation, AI tools, production AI, developer workflow, software testing
- Views: 388
- Reading time: ~4 min read
"GitHub 最新的 LLM 评估指南提醒团队和个人:不要只看演示效果,而要用真实任务、人工复核和回归测试判断 AI 工具。"
快速摘要
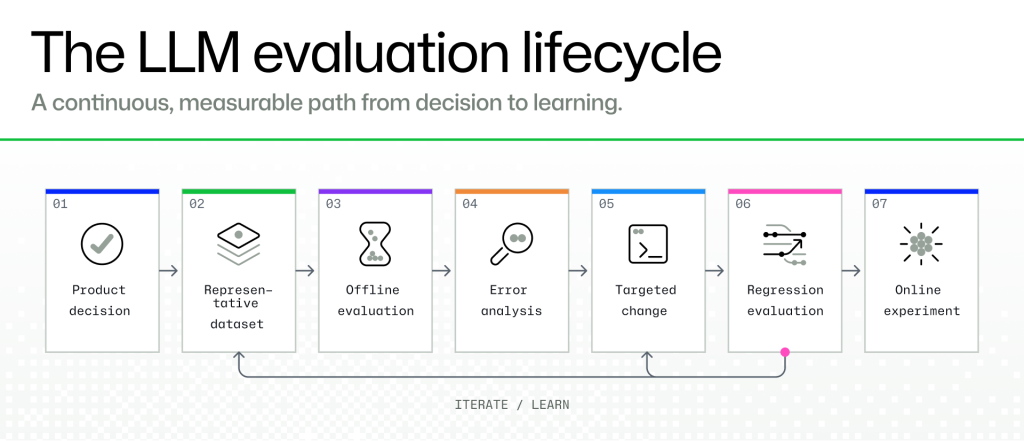
GitHub 最新发布的 LLM 上线前评估文章 https://github.blog/ai-and-ml/llms/how-to-evaluate-llms-before-production/ 提醒我们,选择 AI 工具不能只看演示有多惊艳。更可靠的方法是形成闭环:先明确产品决策,准备代表性样本,运行离线测试,让人工复核低置信度和高影响结果,再做有针对性的修改、回归测试和小范围上线。对 BTTC 读者来说,这套方法同样适用于代码助手、文档总结器、自动化工具以及任何准备下载的 AI 软件。
为什么现在需要评估 LLM
AI 功能正在从实验走向日常工作。团队用它审查代码、总结文档、回复客服、分类工单、搜索代码库和自动执行重复任务。模型和产品选择也越来越多,包括 GitHub Copilot、云端 API、本地模型、浏览器代理和工作流自动化工具。因此真正的问题变成:在 AI 接触生产任务前,如何知道它是否足够可靠?
先定义决策而不是模型
常见错误是从排行榜或发布会开始。更好的评估应从任务开始:你是在选择代码搜索助手、客服机器人、PDF 总结器,还是能修改文件的代理?不同任务风险不同。代码工具要保留测试并解释差异;客服工具不能自信地编造政策;研究助手必须给出来源并区分事实和猜测。
建立小而真实的测试集
你不一定需要庞大基准,但需要能暴露失败模式的样本。包含简单案例、模糊案例、高影响案例,以及正确做法是拒绝或要求澄清的案例。个人可以保存十到三十个真实任务来比较应用;团队则应标注期望结果并说明依据。人工复核仍然重要,因为低置信度、模型与标签不一致、高风险输出都可能被平均分掩盖。
把评估变成软件流程
好的 AI 评估像普通软件质量流程。把提示词、数据集、模型设置和评分记录纳入版本管理;修改提示词或更换模型前先运行离线测试;修复一个问题后重新运行旧案例,确认没有破坏其他任务。风险较高时,应先做小流量实验并准备回滚路径。需要搭建工具栈时,可以从 https://www.bttc.site/software 比较编辑器、测试工具、PDF 工具和安全辅助软件。
信任 AI 工具前的检查清单
第一,写清任务和错误代价。第二,用真实样本测试,而不是只看厂商示例。第三,同时评分准确性、引用、速度、成本、拒绝质量、隐私和可恢复性。第四,让人工审查影响用户、资金、安全或合规的输出。第五,每次提示词、模型或工具改变后都做回归测试。第六,记录上线边界,避免工具悄悄扩展到更高风险工作。更多工具选择文章可继续阅读 https://www.bttc.site/blog 。
常见问题
LLM 评估只适合开发者吗?
不是。开发者需要正式测试,普通用户也能用真实任务、来源检查、权限审查和小范围试用比较 AI 应用。
AI 工具最大的危险信号是什么?
如果工具给出自信答案,却没有来源、复核控制、日志或回滚路径,就不应让它处理重要工作。
团队多久需要重新评估?
每当提示词、模型、检索来源、权限或产品行为改变时,都应重新运行评估。
结论
LLM 评估正在成为软件选择的常规环节。真正领先的团队不是最先采用每个新模型的团队,而是能用真实任务测试、从失败中学习,并让人类持续验证关键输出的团队。