Checklist de avaliação de LLM antes da produção
O guia recente do GitHub sobre avaliação de LLM mostra como equipes e usuários podem testar ferramentas de IA antes de confiar nelas em fluxos reais.
Resumo do Artigo
This article covers Checklist de avaliação de LLM antes da produção. O guia recente do GitHub sobre avaliação de LLM mostra como equipes e usuários podem testar ferramentas de IA antes de confiar nelas em fluxos reais.
Pontos-Chave
- Published: September 1, 2026
- Category: AI Software
- Tags: LLM evaluation, AI tools, production AI, developer workflow, software testing
- Views: 386
- Reading time: ~9 min read
"O guia recente do GitHub sobre avaliação de LLM mostra como equipes e usuários podem testar ferramentas de IA antes de confiar nelas em fluxos reais."
Resumo para agir
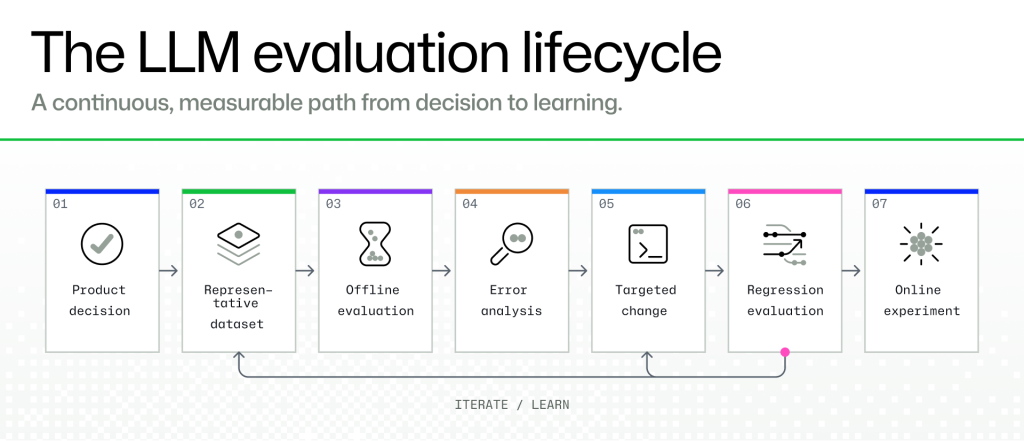
O novo guia do GitHub sobre avaliação de LLM antes da produção, em https://github.blog/ai-and-ml/llms/how-to-evaluate-llms-before-production/ , lembra que ferramentas de IA não devem ser escolhidas apenas pela melhor demonstração. O padrão útil é um ciclo: definir a decisão de produto, montar exemplos representativos, rodar testes offline, revisar erros com humanos, fazer mudanças específicas, repetir regressões e só então ampliar o uso. Para leitores da BTTC, a mesma lógica vale para assistentes de código, resumidores de documentos, automações e qualquer utilitário de IA.
Por que avaliação de LLM ganhou urgência
Recursos de IA saíram do laboratório e entraram no trabalho diário. Equipes usam modelos para revisar código, resumir PDFs, responder clientes, classificar tickets, pesquisar repositórios e automatizar tarefas repetitivas. Ao mesmo tempo, as opções se multiplicam entre GitHub Copilot, APIs em nuvem, modelos locais, agentes de navegador e plataformas de workflow. A pergunta prática é simples: como saber se uma ferramenta é boa o suficiente antes de tocar produção?
Comece pela decisão e não pelo ranking
O erro comum é abrir um leaderboard ou acreditar em um lançamento chamativo. Uma avaliação melhor começa pela tarefa. Você precisa escolher uma ferramenta para busca em código, atendimento, resumo de PDF ou edição automática de arquivos? Cada uso tem riscos diferentes. Uma ferramenta de código precisa preservar testes e explicar diffs. Um bot de suporte não pode inventar políticas com confiança. Um assistente de pesquisa deve citar fontes e separar fatos de suposições.
Monte um conjunto pequeno e honesto
Você não precisa de um benchmark gigante para tomar decisões melhores. Precisa de exemplos que revelem falhas prováveis: casos fáceis, ambíguos, de alto impacto e situações em que a resposta correta é pedir esclarecimento ou recusar. Usuários individuais podem salvar dez a trinta tarefas reais. Equipes devem registrar a saída esperada e o motivo do rótulo. A revisão humana continua essencial, principalmente em baixa confiança, discordância entre modelo e rótulo e decisões de impacto alto.
Transforme a avaliação em fluxo de software
Um bom processo de IA parece qualidade de software. Guarde prompts, conjuntos de dados, configurações e notas de pontuação com histórico. Rode testes offline antes de trocar modelo ou prompt. Depois de uma mudança, repita casos antigos para garantir que a correção não quebrou outra tarefa. Em usos sensíveis, faça experimento limitado e tenha rollback. Para montar esse fluxo, compare editores, ferramentas de teste, PDFs e utilitários de segurança em https://www.bttc.site/software .
Checklist antes de confiar em uma ferramenta
Defina a tarefa e o custo do erro. Use exemplos reais, não apenas demos do fornecedor. Avalie precisão, citações, latência, custo, privacidade, qualidade de recusa e recuperação. Coloque revisão humana quando a saída afeta usuários, dinheiro, segurança ou obrigações legais. Repita regressões sempre que prompt, modelo, fontes ou permissões mudarem. Usuários comuns podem aplicar a versão simples: testar com dados não sensíveis, comparar com fonte confiável, verificar permissões e evitar conectar contas cedo demais. Veja mais guias em https://www.bttc.site/blog .
Perguntas frequentes
Avaliação de LLM é só para desenvolvedores?
Não. Desenvolvedores precisam de testes formais, mas usuários também podem comparar apps com tarefas reais, checagem de fontes, permissões e pequenos testes.
Qual é o maior sinal de alerta?
Uma ferramenta que responde com confiança sem fontes, controles de revisão, registros ou rollback não deve lidar com trabalho importante.
Quando a equipe deve reavaliar?
Sempre que prompts, modelos, fontes de recuperação, permissões ou comportamento do produto mudarem.
Conclusão
Avaliar LLM virou parte normal da escolha de software. Equipes vencedoras testam com trabalho representativo, aprendem com falhas e conectam IA a fluxos que humanos ainda conseguem verificar.