本番前のLLM評価チェックリスト
GitHubの新しいLLM評価ガイドは、AIツールを重要な業務に入れる前に実タスク、人的レビュー、回帰テストで確認する方法を示しています。
この記事の要約
This article covers 本番前のLLM評価チェックリスト. GitHubの新しいLLM評価ガイドは、AIツールを重要な業務に入れる前に実タスク、人的レビュー、回帰テストで確認する方法を示しています。
ポイント
- Published: September 1, 2026
- Category: AI Software
- Tags: LLM evaluation, AI tools, production AI, developer workflow, software testing
- Views: 384
- Reading time: ~6 min read
"GitHubの新しいLLM評価ガイドは、AIツールを重要な業務に入れる前に実タスク、人的レビュー、回帰テストで確認する方法を示しています。"
要点サマリー
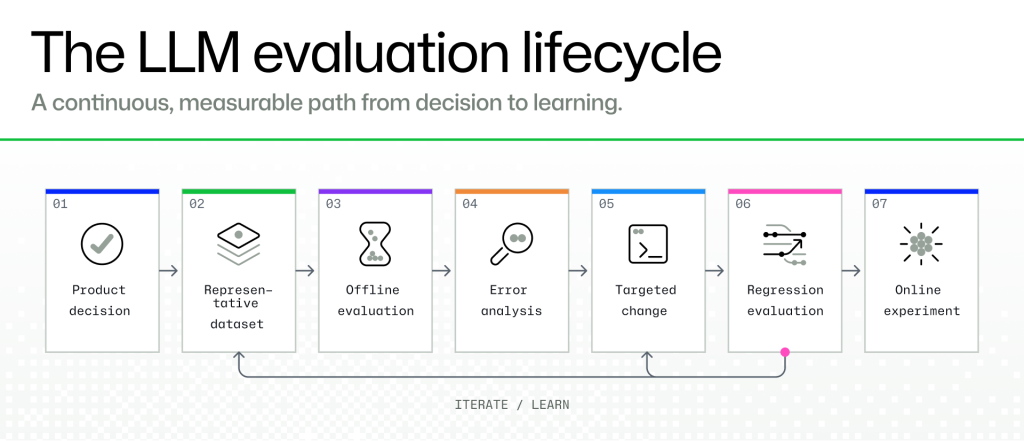
GitHubが公開した本番前のLLM評価ガイド https://github.blog/ai-and-ml/llms/how-to-evaluate-llms-before-production/ は、AIツールを派手なデモだけで選んではいけないことを示しています。役立つ流れは、製品上の判断を定義し、代表的な例を集め、オフラインで評価し、人がエラーを確認し、狙った変更を加え、回帰テストを行い、最後に限定的に展開することです。BTTCの読者がコード支援、文書要約、自動化ツール、AIユーティリティを選ぶときにも同じ考え方が使えます。
なぜ今LLM評価が重要なのか
AI機能は実験から日常業務に入りました。チームはプルリクエストの確認、PDFの要約、サポート回答、チケット分類、コード検索、反復作業の自動化にモデルを使っています。同時に、GitHub Copilot、クラウドAPI、ローカルモデル、ブラウザエージェント、ワークフロー製品など選択肢は増え続けています。重要な質問は、AIが本番作業に触れる前に十分信頼できるかをどう判断するかです。
モデルより先に仕事を決める
よくある失敗はランキングや新製品の印象から始めることです。良い評価はタスクから始めます。コード検索の助手なのか、サポートボットなのか、PDF要約なのか、ファイルを編集するエージェントなのかでリスクは違います。コードツールはテストを守り差分を説明する必要があります。サポートボットはポリシーを作り話してはいけません。調査支援は出典を示し、事実と推測を分ける必要があります。
小さくても正直なテスト集を作る
巨大なベンチマークがなくても判断は改善できます。必要なのは失敗しやすい例です。簡単なケース、あいまいなケース、影響が大きいケース、正しい対応が確認や拒否になるケースを入れます。個人なら十から三十個の実タスクで比較できます。チームなら期待する出力と理由を記録します。人的レビューは今も重要で、低信頼、ラベル不一致、高影響の出力は平均点では隠れやすいからです。
評価をソフトウェア工程にする
良いAI評価は通常の品質管理に似ています。プロンプト、データ、モデル設定、採点メモを履歴付きで保存します。プロンプトやモデルを変える前にオフラインテストを実行します。修正後は古いケースも再実行し、別の作業を壊していないか確認します。リスクが高い場合は小さく公開し、戻せる手順を用意します。周辺ツールを選ぶときは https://www.bttc.site/software でエディタ、テストツール、PDFツール、安全補助ツールを比較できます。
信頼する前の確認項目
まずタスクと失敗時の影響を書きます。次にベンダーの例ではなく実例で試します。精度、引用、速度、費用、拒否の質、プライバシー、復旧しやすさを見ます。ユーザー、金銭、セキュリティ、法務に影響する出力は人が確認します。プロンプト、モデル、検索元、権限が変わったら回帰テストを繰り返します。個人利用でも、機密でないファイルで試し、信頼できる情報と比べ、権限を確認し、早すぎるアカウント連携を避けるべきです。関連記事は https://www.bttc.site/blog で読めます。
個人ユーザーへの応用
個人でAIアプリを選ぶ場合も、評価を難しく考えすぎる必要はありません。まず同じ入力を複数の候補に与え、どのツールが根拠を示し、どのツールが不明点を認めるかを見ます。次に、出力をそのまま使うのではなく、元資料や公式情報と照合します。PDF要約、翻訳、コード生成、画像編集のような用途では、便利さだけでなく、保存場所、権限、エクスポート方法、解約後のデータ扱いも確認します。
チーム導入時の追加ルール
チームで使う場合は、誰が評価セットを管理し、誰が失敗例を承認し、どのデータを入力してよいかを決めておくべきです。評価結果は一度作って終わりではなく、新しいモデル、価格変更、権限変更、連携先追加のたびに更新します。小さなチェックリストでも、導入理由、禁止用途、レビュー担当、ロールバック方法を明記すれば、AIツールが知らないうちに重要な業務へ広がるリスクを下げられます。
ダウンロード前に見る品質シグナル
実際にソフトウェアをダウンロードする前には、更新履歴、サポート文書、権限説明、価格条件、データ削除方法を確認します。AI機能がある場合は、モデル名だけでなく、入力データが保存されるか、学習に使われるか、人が結果を確認できるかも重要です。レビューが多くても、自分の用途とリスクに合わなければ安全とは言えません。短い試用、明確な停止方法、代替ツールの比較を組み合わせると、話題性より実用性で選びやすくなります。重要なのは、AI機能を特別扱いしすぎず、通常のソフトウェアと同じように更新、権限、費用、サポート、失敗時の対処を確認することです。そうすれば新しいモデルが登場しても、毎回同じ基準で落ち着いて比較できます。評価メモを残しておくと、後で似た用途のツールを選ぶときにも再利用できます。小さな記録が、次のダウンロード判断を速く安全にします。判断に迷う場合は、すぐ導入せず、権限を減らした状態で再テストしてから選びます。急がない判断が安全です。
よくある質問
LLM評価は開発者だけのものですか?
いいえ。開発者には正式なテストが必要ですが、一般ユーザーも実タスク、出典確認、権限確認、小さな試用でAIアプリを比べられます。
最も大きな警告サインは何ですか?
出典、レビュー機能、ログ、ロールバックなしに自信ある回答を出すツールは重要な作業に使うべきではありません。
いつ再評価すべきですか?
プロンプト、モデル、検索ソース、権限、製品動作が変わったときは再評価が必要です。
まとめ
LLM評価はソフトウェア選定の一部になっています。新モデルを最初に使うことより、実際の仕事で試し、失敗から学び、人が検証できる流れにAIを接続することが重要です。