Checklist evaluasi LLM sebelum produksi
Panduan terbaru GitHub tentang evaluasi LLM menunjukkan cara menguji alat AI dengan tugas nyata sebelum dipakai dalam workflow penting.
Ringkasan Artikel
This article covers Checklist evaluasi LLM sebelum produksi. Panduan terbaru GitHub tentang evaluasi LLM menunjukkan cara menguji alat AI dengan tugas nyata sebelum dipakai dalam workflow penting.
Poin Penting
- Published: September 1, 2026
- Category: AI Software
- Tags: LLM evaluation, AI tools, production AI, developer workflow, software testing
- Views: 385
- Reading time: ~9 min read
"Panduan terbaru GitHub tentang evaluasi LLM menunjukkan cara menguji alat AI dengan tugas nyata sebelum dipakai dalam workflow penting."
Ringkasan cepat
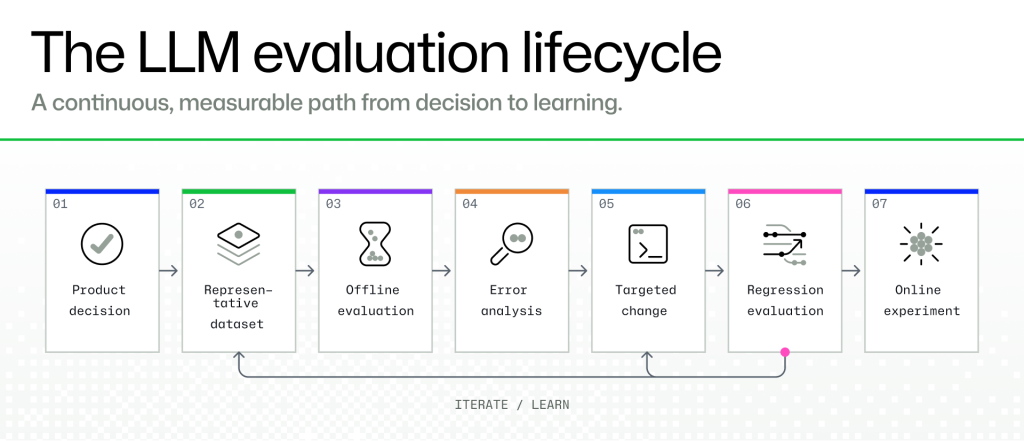
Panduan baru GitHub tentang evaluasi LLM sebelum produksi di https://github.blog/ai-and-ml/llms/how-to-evaluate-llms-before-production/ mengingatkan bahwa alat AI tidak boleh dipilih hanya karena demonya bagus. Pola yang berguna adalah siklus: tentukan keputusan produk, siapkan contoh representatif, jalankan tes offline, minta manusia meninjau kesalahan, lakukan perubahan terarah, ulangi tes regresi, lalu perluas penggunaan secara bertahap. Untuk pembaca BTTC, logika yang sama berlaku saat membandingkan asisten coding, peringkas dokumen, alat otomatisasi, atau utilitas AI lain.
Mengapa evaluasi LLM penting sekarang
Fitur AI sudah masuk ke pekerjaan harian. Tim memakainya untuk meninjau pull request, merangkum PDF, menjawab dukungan, mengklasifikasi tiket, mencari kode, dan mengotomatisasi tugas berulang. Pilihan model juga makin banyak: GitHub Copilot, API cloud, model lokal, agen browser, dan platform workflow. Pertanyaan praktisnya adalah bagaimana tahu alat itu cukup andal sebelum menyentuh pekerjaan produksi.
Mulai dari keputusan, bukan model
Kesalahan umum adalah mulai dari leaderboard atau peluncuran yang ramai. Evaluasi yang lebih baik dimulai dari tugas. Apakah Anda memilih alat pencarian kode, bot dukungan, peringkas PDF, atau agen yang bisa mengedit file? Setiap tugas punya risiko berbeda. Alat kode harus menjaga tes dan menjelaskan diff. Bot dukungan tidak boleh mengarang kebijakan. Asisten riset harus menyebut sumber dan memisahkan fakta dari dugaan.
Buat set tes kecil tetapi jujur
Anda tidak perlu benchmark raksasa untuk membuat keputusan yang lebih baik. Anda perlu contoh yang membuka kemungkinan gagal: kasus mudah, ambigu, berdampak besar, dan kondisi ketika jawaban yang benar adalah meminta klarifikasi atau menolak tindakan. Pengguna pribadi dapat menyimpan sepuluh hingga tiga puluh tugas nyata. Tim harus memberi label output yang diharapkan dan alasan label itu benar. Review manusia tetap penting, terutama untuk keyakinan rendah, perbedaan model dan label, serta kasus berdampak tinggi.
Jadikan evaluasi sebagai workflow software
Proses AI yang baik mirip kualitas software. Simpan prompt, dataset, pengaturan model, dan catatan skor dengan riwayat. Jalankan tes offline sebelum mengganti prompt atau model. Setelah perbaikan, ulangi kasus lama agar perubahan tidak merusak tugas lain. Untuk penggunaan berisiko, mulai dengan traffic terbatas dan jalur rollback. Saat membangun workflow ini, bandingkan editor, alat pengujian, utilitas PDF, dan software keamanan di https://www.bttc.site/software .
Daftar periksa sebelum percaya
Tentukan tugas dan biaya jika jawaban salah. Uji dengan contoh nyata, bukan hanya demo vendor. Nilai akurasi, sitasi, latensi, biaya, privasi, kualitas penolakan, dan kemampuan pemulihan. Libatkan review manusia jika output berdampak pada pengguna, uang, keamanan, atau kewajiban hukum. Ulangi regresi setiap kali prompt, model, sumber, atau izin berubah. Untuk penggunaan pribadi, mulai dengan file tidak sensitif, bandingkan dengan sumber tepercaya, periksa izin, dan jangan terlalu cepat menghubungkan akun. Panduan lain tersedia di https://www.bttc.site/blog .
Pertanyaan umum
Apakah evaluasi LLM hanya untuk developer?
Tidak. Developer memerlukan tes formal, tetapi pengguna biasa juga dapat membandingkan aplikasi dengan tugas nyata, pemeriksaan sumber, izin, dan uji kecil.
Apa tanda bahaya terbesar?
Alat yang memberi jawaban percaya diri tanpa sumber, kontrol review, log, atau rollback tidak layak menangani pekerjaan penting.
Kapan tim harus mengevaluasi ulang?
Setiap kali prompt, model, sumber retrieval, izin, atau perilaku produk berubah.
Kesimpulan
Evaluasi LLM sudah menjadi bagian dari pemilihan software. Tim yang kuat menguji dengan pekerjaan representatif, belajar dari kegagalan, dan menghubungkan AI ke proses yang masih dapat diverifikasi manusia.