Checklist para evaluar LLM antes de producción
La guía reciente de GitHub sobre evaluación de LLM muestra cómo probar herramientas de IA con tareas reales antes de confiar en ellas en flujos importantes.
Resumen del Artículo
This article covers Checklist para evaluar LLM antes de producción. La guía reciente de GitHub sobre evaluación de LLM muestra cómo probar herramientas de IA con tareas reales antes de confiar en ellas en flujos importantes.
Puntos Clave
- Published: September 1, 2026
- Category: AI Software
- Tags: LLM evaluation, AI tools, production AI, developer workflow, software testing
- Views: 383
- Reading time: ~9 min read
"La guía reciente de GitHub sobre evaluación de LLM muestra cómo probar herramientas de IA con tareas reales antes de confiar en ellas en flujos importantes."
Resumen práctico
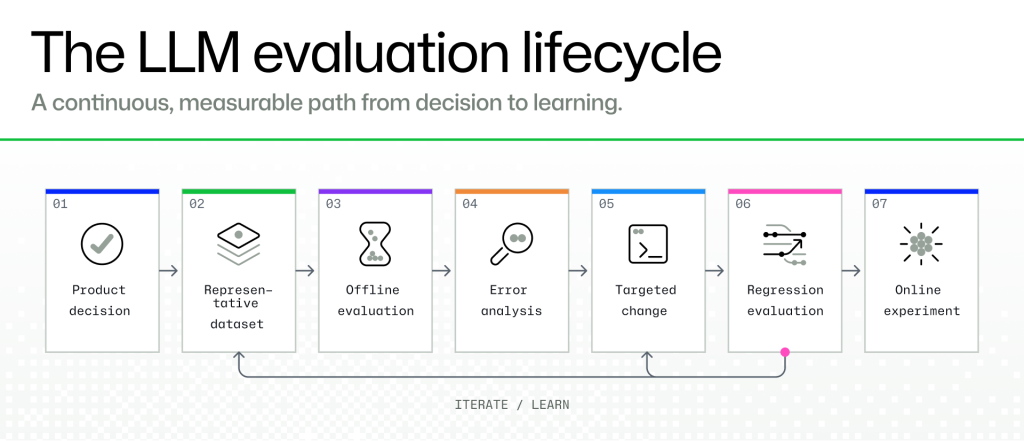
La nueva guía de GitHub sobre cómo evaluar LLM antes de producción, disponible en https://github.blog/ai-and-ml/llms/how-to-evaluate-llms-before-production/ , recuerda que una herramienta de IA no debe elegirse solo por una demo atractiva. El patrón útil es un ciclo: definir la decisión de producto, reunir ejemplos representativos, ejecutar pruebas offline, revisar errores con personas, aplicar cambios concretos, repetir pruebas de regresión y solo entonces ampliar el uso. Para lectores de BTTC, la misma lógica sirve al comparar asistentes de código, resumidores de documentos, automatizaciones o cualquier utilidad de IA.
Por qué la evaluación de LLM importa ahora
Las funciones de IA ya están en el trabajo diario. Los equipos las usan para revisar pull requests, resumir PDFs, responder soporte, clasificar tickets, buscar en repositorios y automatizar tareas repetitivas. A la vez, crecen las opciones entre GitHub Copilot, APIs en la nube, modelos locales, agentes de navegador y plataformas de workflow. La pregunta real es cómo saber si una herramienta es suficientemente fiable antes de tocar producción.
Empieza por la decisión, no por el modelo
El error habitual es comenzar con un ranking o un lanzamiento llamativo. Una evaluación mejor empieza por la tarea. ¿Necesitas búsqueda de código, un bot de soporte, un resumidor de PDF o un agente que edite archivos? Cada caso tiene riesgos distintos. Una herramienta de código debe preservar pruebas y explicar diffs. Un bot de soporte no puede inventar políticas con seguridad. Un asistente de investigación debe citar fuentes y separar hechos de suposiciones.
Crea un conjunto pequeño pero honesto
No necesitas un benchmark enorme para decidir mejor. Necesitas ejemplos que revelen fallos probables: casos fáciles, ambiguos, de alto impacto y situaciones donde la respuesta correcta es pedir aclaración o rechazar la acción. Un usuario individual puede guardar entre diez y treinta tareas reales. Un equipo debe etiquetar salidas esperadas y explicar por qué son correctas. La revisión humana sigue siendo clave cuando hay baja confianza, desacuerdo entre modelo y etiqueta o impacto alto.
Convierte la evaluación en un flujo de software
Un buen proceso de IA se parece a la calidad de software. Guarda prompts, datos, ajustes de modelo y notas de puntuación con historial. Ejecuta pruebas offline antes de cambiar un prompt o un modelo. Después de una mejora, repite casos antiguos para comprobar que no rompiste otra tarea. En usos sensibles, empieza con tráfico limitado y una forma clara de volver atrás. Para construir ese flujo, compara editores, herramientas de prueba, utilidades PDF y software de seguridad en https://www.bttc.site/software .
Lista de control antes de confiar
Define la tarea y el coste de un error. Prueba con ejemplos reales, no solo con demos del proveedor. Mide precisión, citas, latencia, coste, privacidad, calidad del rechazo y recuperación. Añade revisión humana si la salida afecta a usuarios, dinero, seguridad u obligaciones legales. Repite regresiones cuando cambien prompts, modelos, fuentes o permisos. Para uso personal, prueba con archivos no sensibles, compara con fuentes fiables, revisa permisos y evita conectar cuentas demasiado pronto. Hay más guías en https://www.bttc.site/blog .
Preguntas frecuentes
¿La evaluación de LLM es solo para desarrolladores?
No. Los desarrolladores necesitan pruebas formales, pero cualquier usuario puede comparar apps con tareas reales, revisión de fuentes, permisos y pequeñas pruebas.
¿Cuál es la mayor señal de alerta?
Una herramienta que responde con confianza sin fuentes, controles de revisión, registros o rollback no debe manejar trabajo importante.
¿Cuándo debe revaluar un equipo?
Siempre que cambien prompts, modelos, fuentes de recuperación, permisos o comportamiento del producto.
Conclusión
La evaluación de LLM ya forma parte de la selección de software. Los mejores equipos prueban con trabajo representativo, aprenden de los fallos y conectan la IA a procesos que las personas aún pueden verificar.